
Наративите на Си Дзинпин за Китай излизат извън националните граници и намират отражение в най-новите версии на западни чатботове като ChatGPT и Claude. „Репортери без граници“ (RSF) разговаря с американската изследователка Хана Уейт от Университета на Орегон, която ръководи изследване по тази тема.
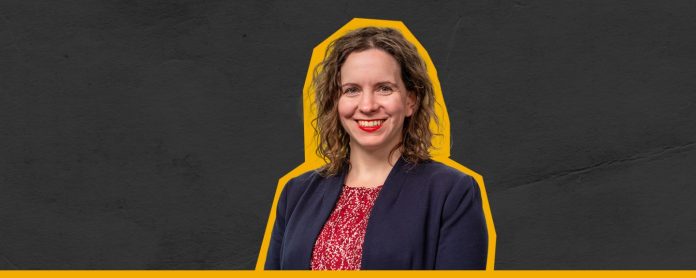
Хана Уейт е доцент по социология в Университета на Орегон и изследва медиите, информационната среда и авторитарната политика. В интервюто си за RSF тя споделя изводите от ново изследване, публикувано в научното списание Nature, за това как контролираните от държавата медии могат да влияят върху големите езикови модели.
Вашето изследване показа, че китайската пропаганда е проникнала в повечето от най-новите западни големи езикови модели. Как това става възможно?
Смятаме, че това е изключително интересен пример за начина, по който контролираните от държавата медии могат да достигнат далеч отвъд първоначалната си среда. Досега голямо внимание се отделяше на два механизма, чрез които влиятелни институции могат да формират поведението на големите езикови модели. Единият е регулацията. Например, когато се появи DeepSeek [китайски чатбот, разработен от едноименната компания], голямо внимание се отделяше на това, че той може да възпроизвежда официалната държавна позиция, тъй като китайската държава упражнява определен регулаторен контрол върху модела. Друг свързан проблем е възможността институциите да влияят върху тези модели чрез собствеността. Такъв е случаят с Grok [чатбот, интегриран в социалната мрежа X].
Хората имат сериозни опасения, че Илон Мъск, собственик на компанията, разработила модела, може да оказва идеологическо влияние върху него. Тези процеси са важни и заслужават да им се обръща внимание от академичните среди и медиите. Нашето изследване обаче е насочено към трети механизъм, чрез който институциите влияят върху резултатите от работата на тези модели — самата информационна среда.
Китай полага значителни усилия да контролира съдържанието в китайския интернет чрез пропаганда и цензура, които насърчават разпространението на определено съдържание. Някъде около средата на първото десетилетие на 21. век започват да се предприемат усилия за архивиране на уебсъдържание чрез инициативи като Common Crawl [организация с нестопанска цел, която обхожда интернет и създава свободно достъпни бази данни с уебсъдържание], като по този начин са събрани огромни количества данни, включително от китайския интернет.
Към края на второто десетилетие на 21. век тези данни започват да се използват повторно за обучението на големи езикови модели. В нашата статия обосноваваме тезата, че включването на координирано от китайската държава медийно съдържание в обучаващите набори от данни на големите езикови модели оказва влияние върху тях. Резултатът е, че моделите генерират повече съдържание, съответстващо на позициите на Китайската народна република (КНР), особено когато запитването [подаването на инструкции] е на китайски език, а не на английски или на други езици, които се различават съществено от китайския.
Става дума до голяма степен за непредвидени последици: първо, решението на контролираните от китайската държава медии да инфилтрират информационната среда; след това — решенията на организациите, създали архивите; и накрая, най-същественото — решенията на компании като OpenAI и Anthropic да извличат тези данни от интернет, да ги третират като неутрален извор на език и знания и да обучават своите модели с тях.
Следователно това е по-скоро страничен ефект, отколкото целенасочена стратегия на китайските власти?
Нямаме доказателства, че китайската държава умишлено е преследвала такава цел. Това дори не би имало логически смисъл, тъй като голяма част от обучаващите данни, които анализирахме, са събрани преди появата на тези модели. Въпреки това нашето изследване откроява една тревожна възможност: след като този механизъм вече се е появил, той променя стимулите на авторитарните режими. Той им дава още една причина да координират информационната среда, защото така могат да влияят не само върху възприятията на собствените си граждани, но и върху моделите, които играят все по-важна роля в нашата по-широка информационна среда.
Това обаче не е процес, отнасящ се само до Китай. В заключителната част на изследването представяме доказателства, че [подобен процес] вероятно протича във всеки авторитарен режим, който полага значителни усилия да осъществява контрол върху медиите и същевременно се характеризира с висока степен на езикова изключителност [например ако основният език в дадена държава се използва почти изцяло в нейните граници]. Една от причините китайската система да оказва подобно влияние е, че има много малко други влиятелни организации, които упражняват съпоставим контрол върху информацията на китайски език. Това важи и за други авторитарни режими като тези във Виетнам и Туркменистан. Смятаме, че същият процес протича и там.
Какво може да се направи, за да се противодейства на разпространението на пропаганда в големите езикови модели?
Това е изключително важен въпрос, който няма непосредствени и лесни отговори. Бих се върнала към казаното в началото: влиянието върху информационната среда е един от няколкото механизма, чрез които властовите институции могат да влияят върху тези модели. Другият е регулацията. Лично аз се опасявам, че регулацията може да бъде използвана за политически цели, особено в Съединените щати. Затова трябва внимателно да преценим различните рискове.
Като автори смятаме, че една от най-важните първи стъпки е прозрачността. Нуждаем се от повече информация за това върху какви данни се обучават тези модели, какво съдържат данните за обучение и как те се променят с течение на времето в зависимост от различните решения, вземани от компаниите. Това е важно за потребителите, за да могат да правят информиран избор кои модели да използват и за какво да ги използват. Важно е и за политиците и органите, отговорни за разработването на политики, за да разбират какво действително съдържат тези изключително сложни системи. Важно е и за организациите, които все по-често внедряват тези модели и им предоставят чувствителни данни — те трябва да знаят произхода на информацията, на която разчитат техните системи.
Един от основните изводи на нашето изследване е, че тези модели на практика изпират информация, като прекъсват връзката ѝ с първоначалния източник. Трябва да възстановим тази връзка. Всеки, който използва подобни модели, трябва да може да установи откъде в крайна сметка произхожда получаваната информация. Реализирането на този принцип обаче е много по-трудно, отколкото формулирането му, предвид сложността на тези системи.
Пълният текст на изследването е достъпен тук.
// RSF